はてなブックマークで、AIを使った作業時間に関するブログ記事が紹介されていました。
・全てのタスクは1時間以内に終わらせる
・1時間で終わらないのならAIではなく人間側が間違っている
1時間はあくまでも経験則の目安であり、合理的な根拠が提示されていなかったので、複数のAIに妥当性を聞いてみました。
以下は、AIで検証した内容を備忘録としてChatGPTにまとめてもらった記事です。
AIによると、最優先すべき基準は「品質」であり、「時間」は2番目以降とのこと。
時短のための工夫やノウハウは重要ですが、主従が逆になると本末転倒ですね。
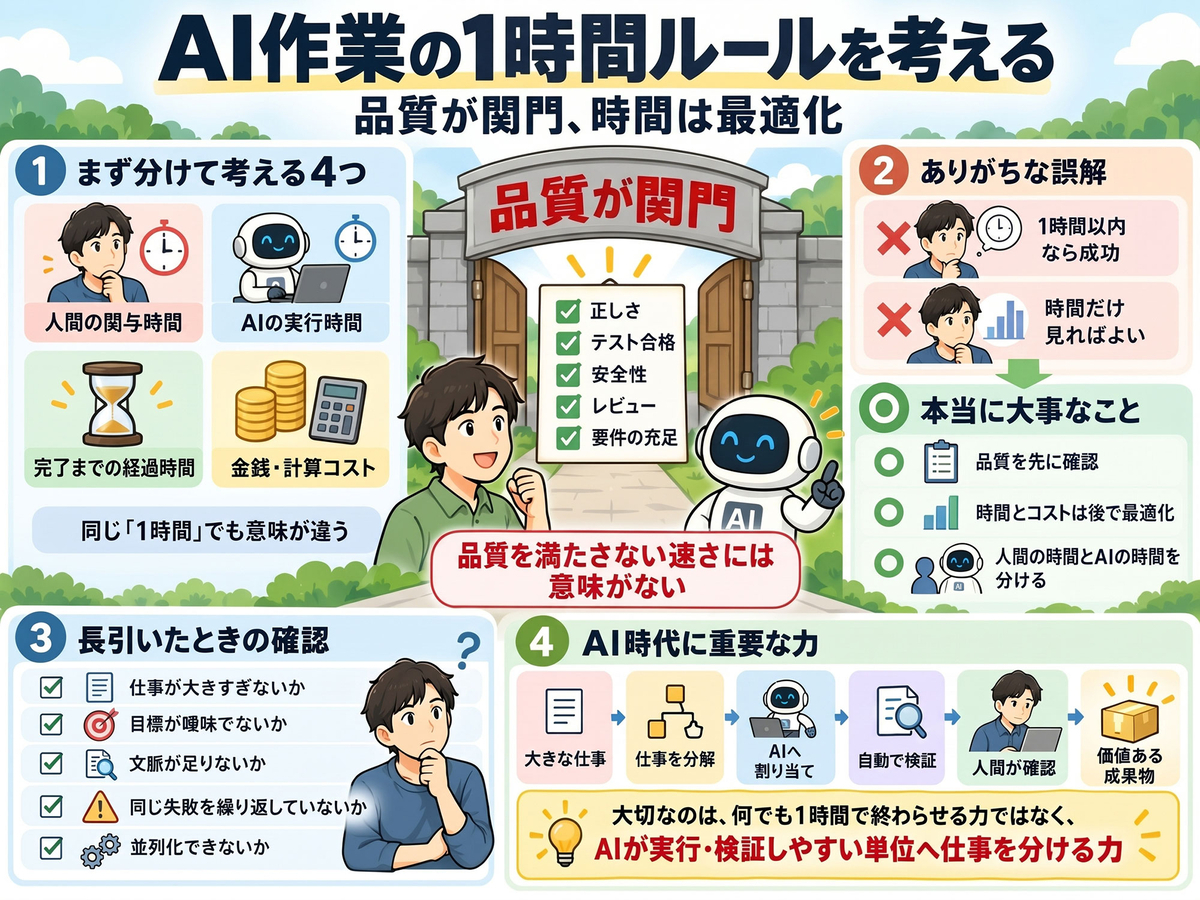
- AIを使った仕事は「1時間以内」に終わらせるべきなのか?
- 元記事の問題提起には参考になる部分が多い
- 違和感の正体:「1時間」とは、いったい誰の時間なのか?
- ① 人間の関与時間を1時間程度にする
- ② 人間+AIを含めた完了時間を1時間以内にする
- Wall-clock timeを絶対に1時間へ収めると何が起きるか
- さらに危険なのは、品質を削って時間を達成すること
- 品質はGate、時間は最適化対象
- 実際、Codexは25時間連続で働いた例もある
- ただし「長ければ長いほど良い」わけでもない
- 2025年の「AIを使うと19%遅くなる」は現在の一般論ではない
- 「15〜60分」という別の数字も出てくる
- Relentless ― 全体を1時間で終えるのではない
- orchestmuxの「15〜60分」は、さらに意味が違う
- Context Rotはある。しかし「60分の壁」ではない
- 本当に重要なのは「AI向けのWBS」ではないか
- AI時代のWork Packageを考える
- 実はPMBOK自身もすでにAI対応を始めている
- 単純な「1時間ルール」と今回の提案を比較する
- 元記事の主張を改めて評価してみる
- では「1時間」は完全に無意味なのか?
- まとめ ― 「1時間」は答えではなく、良い問題提起だった
AIを使った仕事は「1時間以内」に終わらせるべきなのか?
AI時代の時間管理・品質・WBSを考える
はてなブックマークで紹介されていた、手羽先さんの『作業が遅い人は「1時間で終わっているか」を判断軸にすると良い』というnote記事を読みました。
記事の主張を要約すると、
- 全てのタスクを1時間以内に終わらせる
- 1時間で終わらないならAIではなく人間側に問題がある
- AIが1時間以内に仕事を終えられるよう、人間側が改善する
- worktreeやsub agentなどを使って並列化する
- AIが十分に動けるContextやActionを用意する
といった内容です。
非常に刺激的な主張です。
そして、「人間側のAIの使い方がボトルネックになる」という問題提起には、かなり納得できる部分があります。
一方で、どうしても引っかかったのが、
なぜ1時間なのか?
という数字の科学的根拠、出典でした。
さらにChatGPT、Claude、Geminiを使って検証していたら、もっと根本的な疑問に気付きました。
そもそも、その「1時間」は誰が働いている時間なのか?
今回は、この疑問から「AI時代のプロジェクト管理」について考えてみます。
元記事の問題提起には参考になる部分が多い
まず、元記事を全否定するつもりはありません。
むしろ、AIコーディングを実際に使う上で重要な指摘がいくつかあります。
例えば、
- AIに必要なContextを与える
- ブラウザや外部ツールなど必要なActionを利用できるようにする
- タスクを適切に分割する
- 独立した処理なら並列化する
- worktreeなどを利用して作業環境を分離する
- AIが延々と迷走しているなら、人間側の問題設定も疑う
といった考えです。
AIに、
「いい感じに作っておいて」
と曖昧に頼むのと、
「この仕様を満たすAPIを作り、このテストが通れば完了」
と詳しく頼むのでは、当然後者の方が仕事を進めやすいでしょう。
OpenAI自身も、Codexを使った大規模開発について、人間の主な仕事がコードを書くことから、環境を設計し、意図を明示し、Agentが正しく動けるフィードバックループを作ることへ変化したと説明しています。
この意味では、「人間がAIのボトルネックになる」という元記事の指摘は、重要な問題提起となります。
ただし、そこから
「だから全て1時間以内に終わらせる」
という主張へ至るには、かなり飛躍があるように思います。
違和感の正体:「1時間」とは、いったい誰の時間なのか?
AIエージェントを使った作業では、「作業時間」を1つの数字だけで考えると混乱します。 少なくとも、次の4つの指標を分けて考えた方がよいでしょう。
| 指標 | 意味 |
|---|---|
| 人間の関与時間(Human attention / intervention time) | 指示、判断、質問への回答、レビューなど、人間が実際に作業へ関与・拘束される時間 |
| AIの実行時間(AI execution time) | AIエージェントがバックグラウンドで調査、推論、実装、テストなどを行っている時間 |
| 経過時間(Wall-clock completion time) | AIへ依頼してから、要求された品質基準を満たす成果物が完成するまでの実時間 |
| 金銭・計算コスト(Monetary / compute cost) | 料金プラン、API利用料、高性能モデル、並列Agent、計算資源などに投入したコスト |
この4つは別々に考える必要があります。
同じ「1時間」でも、人間が1時間付きっきりなのか、AIだけが1時間動いているのかでは意味がまったく違います。 また、追加コストを投入して経過時間を短縮できたとしても、それだけでAI活用スキルが高いとは判断できません。
この区別をすると、「1時間以内」の意味がまったく変わります。
① 人間の関与時間を1時間程度にする
例えば、
- 人間が30分かけて仕様をAIへ伝える
- AIがバックグラウンドで6時間作業する
- 翌朝、人間が20分レビューする
というケースを考えます。
AIは6時間動いています。
他方、人間が実際に拘束されたのは合計50分です。
この間、人間は別の仕事をしてもよいし、食事をしてもよいし、寝ていても構いません。
AIエージェントの利用が本格化してくると、この区別は非常に重要になってきます。
OpenAIは、CodexをAgent中心で使った開発について、希少な資源はhuman time and attention(人間の時間と注意力)だと説明しています。
しかも、単一のCodex実行が一つのタスクについて6時間以上動くことも珍しくなく、人間が寝ている間に動いていることもあるとしています。
つまり、
AIが6時間働いた=人間も6時間拘束された
ではありません。
この意味で「人間がAIに付きっきりになる時間を減らす」という目標なら、非常に合理的です。
ただし、
人間の関与時間も必ず1時間以下にする
と決めてしまうと、また別の問題が起きます。
例えば、銀行の勘定系システムのような巨大なシステム開発なら、レビューだけで何時間、何日とかけることも必要でしょう。
したがって、
人間の1回の集中セッションを適切な長さに区切る
ことと、
人間の総レビュー時間を1時間以内に制限する
ことは別です。
② 人間+AIを含めた完了時間を1時間以内にする
もう一つの読み方があります。
AIへ依頼してから成果物が完成するまでのWall-clock timeそのものを1時間以内にするという意味です。
元記事では、
「自分なら1時間で終わる仕事を、他のメンバーは2〜3時間かけている」
という比較があり、さらにworktreeやsub agentによる並列作業を解決策として挙げています。
並列化によって主に縮むのは、人間の注意時間というより完了までの経過時間です。
そのため、元記事は①と②を明確に区別しておらず、少なくとも②の意味でも読むことができます。
もちろん著者本人が頭の中でどちらを意図していたかまでは分かりません。
しかし、この2種類の時間を明確に区別しないまま、
1時間以内かどうかでAI活用の成否を判定する
と断定するのは問題があります。
Wall-clock timeを絶対に1時間へ収めると何が起きるか
例えば、大きなAI開発タスクを何が何でも1時間以内にしたいとします。
そうすると、
- Agentを大量に並列実行する
- より高性能なモデルを使う
- API使用量を増やす
- より大きな計算資源を投入する
ことで、処理時間を短くできる場合があります。
つまり、ある意味ではお金で時間を買うことができます。
もちろん、これは悪いことではありません。
1時間の人件費が非常に高ければ、数千円多くAIへ払って30分短縮する方が合理的なこともあります。
問題なのは、
お金を投入して速くした
ことと、
AIを使う能力が上達した
ことを、同じ「1時間以内」というKPIでは区別できないことです。
高額なモデル、多数のAgent、大量の計算資源による「力技」でも時間は短くなる場合があります。
逆に、安価な構成でバックグラウンド処理を長時間回す方が合理的なケースもあります。
したがって、
作業時間だけからAI利用能力を判断することはできない
という別の結論も導かれます。
さらに危険なのは、品質を削って時間を達成すること
もっと大きな問題があります。
1時間という時間が最上位KPIになると、
- テストを減らす
- レビューを省略する
- セキュリティ確認を後回しにする
- 根本原因ではなく症状だけ修正する
- 「とりあえず動く」状態で完成扱いにする
という方向へ最適化される可能性があります。
AIが50分で大量のコードを書いてくれても、重大なバグが残っていれば意味がありません。
そこで今回の議論で、最も腑に落ちた考え方がこれです。
品質は満たすべき「関門(Gate)」であり、時間はそのGateを通過した後に縮める「最適化対象」である。
品質はGate、時間は最適化対象
システム開発では、まず満たすべき条件が存在しています。
| Gate | 例 |
|---|---|
| 要件適合 | 要求された機能を実装している |
| テスト | 必要なテストに合格している |
| セキュリティ | 必要な安全確認が終わっている |
| レビュー | リスクに応じた確認を行った |
| 法令・規則 | 必要なルールに適合している |
これらを満たした後で、
- Human Attention Time (人間の関与時間)
- AI Execution Time (AIの実行時間)
- Wall-clock Completion Time (経過時間)
- Monetary Cost (金銭コスト)
- Token / Compute Cost (トークン・計算コスト)
- 再作業量
を減らす。
この順番です。
言い換えれば、
品質を満たさない速さには意味がない。
一方で、
品質さえ良ければ何時間かかってもいい
という意味でもありません。
品質条件を満たした上で、速く、安く、人間の負担が少ない方がよい。
つまりこれは制約条件付き最適化として考えると分かりやすいです。
実際、Codexは25時間連続で働いた例もある
「AI作業が1時間を超えれば使い方が悪い」という考えへの分かりやすい反例があります。
OpenAIは2026年2月、GPT-5.3-Codexへ空のリポジトリからデザインツールを作らせる実験を公開しました。
Codexは約25時間連続で動き、約1,300万トークンを使い、約3万行のコードを生成しました。
重要なのは、25時間放置して好き勝手にコードを書かせたわけではないことです。
OpenAIは、
- spec
- plan
- constraints
- status
などをMarkdownファイルとして残し、Codexが繰り返し参照できるようにしました。
さらに各マイルストーンで、
- tests
- lint
- typecheck
を実施しています。
OpenAIはこれをdurable project memory(永続的なプロジェクトメモリ)という考え方で説明しています。
要するに、
長時間だから悪い
のではありません。
長時間でも、状態・仕様・完了条件・検証方法を維持できるか
が重要なのです。
ただし「長ければ長いほど良い」わけでもない
ここも逆方向へ誤解してはいけません。
METR(Model Evaluation and Threat Research)は「time horizon」という指標で、AIがどれくらい大きな仕事を完遂できるかを研究しています。
ただし、この「2時間」「8時間」といった数字は、
AI自身が2時間・8時間動いた
という意味ではありません。
人間の専門家ならそのくらいかかる難易度のタスクを基準にして、AIの成功確率を測っています。
METR自身も、
time horizonはAIが自律的に何時間動けるかを示す値ではない
と明記しています。
長く複雑なタスクほど一般的には難しくなります。
だからこそ、大きな仕事をそのまま投げるのではなく、AIが扱いやすい単位へ分解する設計が重要になります。
2025年の「AIを使うと19%遅くなる」は現在の一般論ではない
AIコーディングについてよく引用される研究に、METRが2025年に行った実験があります。
経験豊富なOSS開発者を対象にした当時の実験では、AIを使った場合にタスク完了時間が約19%長くなりました。
しかも開発者本人は、AIによって約20%速くなったと感じていました。
これは「体感速度と実測がずれることがある」という興味深い結果です。
ただし、2026年現在、
AIを使うと19%遅くなる
という一般論として使うのは不適切です。
METRは2026年2月の更新で、現在の開発者は2025年初めよりAIによって速くなっている可能性が高いと考えている一方、参加者の選択バイアスなどにより、正確な改善幅を測ることが難しくなっていると説明しています。
さらに面白いのが、
Agentが処理している間に別の仕事をする
開発者が増えたため、「このタスクに何分使ったのか」を測ること自体が難しくなっているという点です。
まさに今回の、
人間の時間とAIの時間を分けて考える必要がある
という話につながります。
「15〜60分」という別の数字も出てくる
調べている途中で、AIコーディング用OSSにも「15〜60分」という数字が出てきました。
一見すると、
やはりAIの仕事は1時間以内が良いのでは?
と思います。
しかし、その内容を調べると意味合いが全然違います。
Relentless ― 全体を1時間で終えるのではない
Relentlessは、Claude Code、Codex、GeminiなどのAI coding agentを繰り返し動かすオーケストレーションツールです。
READMEでは、
- Agentをiterationごとにfresh contextで起動する
- 過去の状態はgit commitやprogress fileへ残す
- Taskを小さなstoryへ分割する
- TDDやE2E testを利用する
という仕組みを採用しています。
そして、
1つのstoryは1 context window、15〜60分程度で終えられる大きさにする
という経験則を採用しています。
ただし重要なのは、
プロジェクト全体を60分以内に終える
という発想ではないことです。
むしろ逆です。
AIを何度もfresh contextで再起動し、
小さなタスク
↓
実装
↓
テスト
↓
commit・状態保存
↓
fresh context
↓
次のタスク
と繰り返すことによって、長時間のプロジェクトを継続させる仕組みです。
15〜60分は科学的な最適時間ではなく、このOSSで採用されている設計上の経験則です。
orchestmuxの「15〜60分」は、さらに意味が違う
orchestmuxにも、
Real tasks run 15–60 minutes
という記述があります。
ところが、こちらはタスクを15〜60分に分解しろというルールではありません。
orchestmuxのwaitコマンドは標準では540秒ほどでtimeoutします。
しかしREADMEでは、
timeoutは失敗とは限らない。実タスクは15〜60分動くので、必要なら再びwaitする
という趣旨で説明されています。
つまり、
- Relentlessの15〜60分:タスクサイズの経験則
- orchestmuxの15〜60分:Workerが実際に動くことのある時間
です。
同じ数字でも意味が全く違います。
これは今回の議論を象徴しているように思います。
数字だけを取り出して、
「AIでは60分が正解」
と一般化してはいけないのです。
Context Rotはある。しかし「60分の壁」ではない
長いコンテキストについては、実際に問題があります。
Chromaは2025年、18種類のLLMを使って、入力が長くなるにつれて性能が不安定になる「Context Rot」(コンテキスト腐敗)を検証しています。
最新モデルを含め、長い入力では性能が一様ではなくなり、関連情報だけに絞った入力の方が高い性能を示すケースが確認されています。
したがって、
巨大なContextを無制限に積み上げればよい
とは言えません。
しかし、この研究から、
15分を超えると危険
35分が限界
60分を超えると品質が落ちる
という時間の閾値が導かれるわけではありません。
Contextの長さとwall-clock timeは別物です。
ここも混同しない方がよいでしょう。
本当に重要なのは「AI向けのWBS」ではないか
ここまで考えて、従来のプロジェクト管理にあるWBS(Work Breakdown Structure:作業分解構成図)が連想されました。
巨大なプロジェクトを、そのまま「1タスク」として人間へ渡すことはありません。
大きな仕事を分解し、管理可能な単位にしていきます。
人間向けのプロジェクト管理でも、8/80ルールなど、作業単位の大きさについてさまざまな経験則があります。
しかしPMI掲載の別資料では20〜80時間という目安も提案されており、8/80が絶対的な法則というわけではありません。
AIでも同じだと思います。
重要なのは、
「全部1時間以内」
という数字ではなく、
AIが独立して実行・検証可能な単位まで仕事を分解すること
でしょう。
例えば、AIへ渡す仕事について、
- Goalが明確か
- 目的が一つに絞られているか
- 必要なContextが揃っているか
- Definition of Doneが明確か
- テストで合否判定できるか
- 失敗してもrollbackできるか
- 依存関係が分かっているか
- 並列化できるか
- 人間がレビューできる大きさか
- 必要以上の権限を与えていないか
- 中間状態を保存して再開できるか
といった条件を見る方が合理的です。
AI時代のWork Packageを考える
従来のプロジェクト管理を単純化すると、
プロジェクト(Project)
↓
成果物(Deliverable)
↓
ワーク・パッケージ(Work Package)
↓
アクティビティ(Activity)
のように仕事を分解します。
AIエージェントが「作業者」になるなら、さらに、
ワーク・パッケージ(Work Package)
↓
AIタスク分解(AI Task Decomposition)
↓
エージェントへの割り当て(Agent Assignment)
↓
自律実行(Autonomous Execution)
↓
自動検証(Automated Verification)
↓
AI/人間によるレビュー(AI / Human Review)
↓
受入れ(Acceptance)
のような層を考えてもよいのではないでしょうか。
これはPMI公式の定義ではなく、今回の議論から考えた私なりの仮説です。
従来は、
誰という人間に仕事を割り当てるか
が重要でした。
これからは、
人間にやらせるか
Codexにやらせるか
Claude Codeにやらせるか
複数Agentへ並列配分するか
どこで人間へ戻すか
まで含めて設計する必要があります。
この能力は、「コードを書く能力」とは別の重要なスキルになりそうです。
実はPMBOK自身もすでにAI対応を始めている
当初私は、「AI時代になればPMBOKもいずれ改訂されるだろう」と考えていました。
しかし調べてみると、すでに始まっていました。
PMBOK Guide 第8版は2025年11月に刊行され、PMI公式ページではAI、PMO、調達について扱いを拡充したとされています。第8版には「Artificial Intelligence」というAppendix X3もあります。
さらにPMIは2026年6月、
『The Standard for Artificial Intelligence in Portfolio, Program, and Project Management』
を公開しています。
つまり、
AI時代のPMBOKはこれから始まる
のではなく、
PMI自身もすでにAI時代への対応を始めている
というのが正確でした。
ただし、AIコーディングエージェントを実際の作業者として、
- どの大きさの仕事を渡すか
- どの程度の権限を与えるか
- どこまで自動テストへ任せるか
- どの地点でHuman-in-the-Loop(人間の介在)へ戻すか
という実務には、今後さらにノウハウが蓄積していく余地がありそうです。
単純な「1時間ルール」と今回の提案を比較する
| 評価軸 | 単純な1時間ルール | 今回の考え方 |
|---|---|---|
| 最優先 | 経過時間 | 品質・安全性・検証可能性 |
| Human Time (人間の時間) | AI時間と混同しやすい | 独立して測定 |
| AI Time (AIの時間) | 1時間超を問題視 | 必要なら長時間も許容 |
| Wall-clock (経過時間) | 1時間以内 | 品質条件下で短縮 |
| コスト | 見えにくい | 時間とのtrade-offで評価 |
| タスク粒度 | 時間を基準にする | Goal・Context・DoD・Test等を基準にする |
| 成功判定 | 速さ | 検証済み成果物+時間+コスト |
こうして比べると、
「1時間」という時間そのものが問題
というより、
異なる時間・品質・コストを全部一つのKPIへ押し込んでいること
が問題なのだと思います。
元記事の主張を改めて評価してみる
| 主張 | 私の評価 |
|---|---|
| 人間がAIのボトルネックになる | 妥当 |
| ContextやActionを整える | 妥当 |
| タスク分解が重要 | 妥当 |
| worktreeを使う | 条件付きで有用 |
| sub agentで並列化する | 条件付きで有用 |
| 作業時間を計測する | 有用 |
| 全タスク1時間以内 | 一般化する根拠が不足 |
| 1時間を超えたら人間が悪い | 過剰一般化 |
| 1時間以内ならAIを正しく使えている | 成立しない |
| AI利用者間で10〜100倍差が出る | 筆者の経験談としてはあり得るが一般化の根拠不足 |
| 作業時間だけをKPIにする | 初心者には特に誤解を招きやすい |
また、「1週間かかった仕事が1時間で終わった」という事例も興味深いですが、
- 全体図を書いた
- ボトルネックを洗い出した
- worktreeを使った
- sub agentを使った
など複数の介入を同時に行っています。
しかも「問題は全く別の場所にあった」とされています。
したがって、この一例だけから、
sub agentを使えば1週間が1時間になる
などと因果関係を切り出すことはできません。
では「1時間」は完全に無意味なのか?
私はそうは思いません。
例えば、
1時間たっているのに、AIが同じエラーを何度も繰り返している
なら、一度止めた方がよいでしょう。
- タスクが大きすぎないか
- Goalが曖昧ではないか
- Context不足ではないか
- 必要なツールがないのではないか
- AIがループしていないか
- 人間側の前提が間違っていないか
- 並列化した方がよくないか
- 中間状態を保存してfresh contextから再開すべきではないか
を確認する。
つまり「1時間」を、
達成目標
ではなく、
警告灯
として使うわけです。
ただし警告灯が点灯する時間は、15分かもしれませんし、2時間かもしれません。
銀行システムと変数名の変更で、同じ時間を設定する理由はありません。
タスクの規模・リスク・見積りに応じて変えればよいでしょう。
まとめ ― 「1時間」は答えではなく、良い問題提起だった
今回、元記事についてChatGPT、Claude、Geminiへ繰り返し質問し、互いの回答を検証しました。
最初は、
「1時間という数字に根拠がないのでは?」
という単純な疑問でした。
しかし考えていくうちに、
そもそも人間の1時間とAIの1時間は違う
というところに行き着きました。
AIエージェント時代には、
- Human Attention Time
- AI Execution Time
- Wall-clock Completion Time
- Monetary / Compute Cost
を分離して考える必要があります。
そして、何より先に品質があります。
品質が関門。時間は関門を通過した後に最適化する。
AIが1時間以内に仕事を終えられなければ失敗、という単純な話ではありません。
まず、
- 品質
- 安全性
- 要件適合
- 必要な検証
を満たす。
その上で、
- 人間の注意時間
- AIの実行時間
- 完了までの経過時間
- コスト
をそれぞれ最適化する。
AI時代に重要なのは、
「何でも1時間以内に終わらせる能力」
ではなく、
大きな仕事をAIが自律的に実行・検証できる単位へ分解し、人間とAIへ適切に配分できる能力
なのだと思います。
元記事の「1時間ルール」は、答えそのものとしては一般化しすぎだと思います。
しかし、
人間がAIのボトルネックになっていないか?
AIへ渡す仕事の大きさは適切か?
AI時代のプロジェクト管理はどうあるべきか?
という問題を考えるきっかけにはなりました。
その意味では、非常に面白い問題提起だったと思います。
参考資料
OpenAI「Harness engineering: leveraging Codex in an agent-first world」
OpenAIの資料を開く
OpenAI Developers「Run long horizon tasks with Codex」
OpenAI Developersの資料を開く
METR「Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity」
METR 2025年研究を開く
METR「We are Changing our Developer Productivity Experiment Design」
METR 2026年更新を開く
METR「Task-Completion Time Horizons of Frontier AI Models」
METR Time Horizonsを開く
PMI「PMBOK Guide」
PMBOK Guide 第8版の公式ページを開く
PMI「The Standard for Artificial Intelligence in Portfolio, Program, and Project Management」
PMIのAI標準について読む
GitHub「ArvorCo/Relentless」
Relentlessを開く
GitHub「layl-labs/orchestmux」
orchestmuxを開く
Chroma「Context Rot: How Increasing Input Tokens Impacts LLM Performance」
Context Rotの研究を開く
